DeepSeek V4.1 Flash-1017 发布:单位算力成本降至 1 美元 13 亿 Token
在国产大模型的迭代普遍受到关注的时间点上,DeepSeek 率先交出了新版答卷——V4.1 Flash-1017 正式发布,整体性能较此前版本有显著提升。
关于具体跑分与性能变化,此前已有专门的报道。值得一提的是,DeepSeek 这次自行公布了一张帕累托曲线,也就是业内常说的“AI 斩杀线”。从曲线来看,V4.1 Flash-1017 依旧维持在高水准:单个任务的成本仅为 Fable、Astra 等大模型的 1/50 至 1/100,性价比至少高出四五十倍。
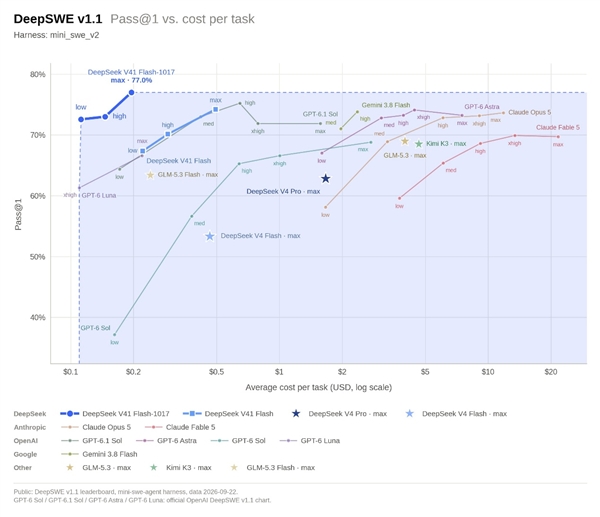
这样的成绩如何实现?业界对 DeepSeek 的工程优化能力已有共识,其在压低成本方面几乎做到了极致。vllm_project 发布的一张对比图表,直观呈现了 DeepSeek 在 AI 硬件层面的优化水平。
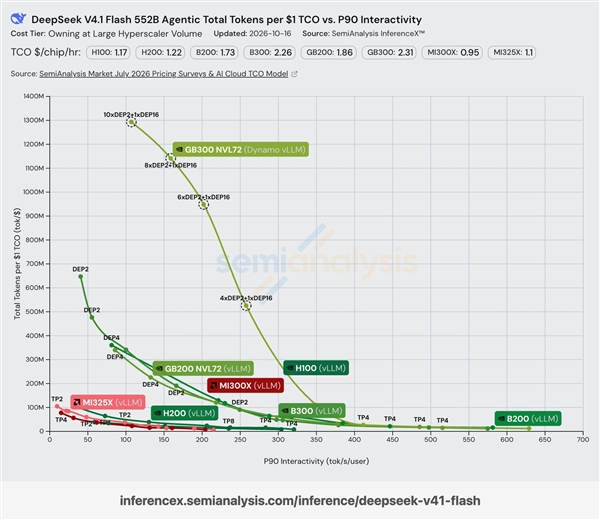
该图表基于 SemiAnalysis AgentX 基准测试,在 GB300 NVL72 与 Dynamo vLLM 平台上,V4.1 Flash 跑出了 1 美元 1.3B Token 的成绩,P90 交互速度超过 100 tok/s/user。
换算下来,1 美元对应 13 亿 Token,即每百万 Token 成本约 0.00077 美元,远低于 V4.1 Flash 自身 0.15 美元的输入定价。
当然,两者并不能直接画等号:1 美元 13 亿 Token 反映的是算力端的 TCO 成本,而 API 定价还需要考虑更多变量。不过,超低的底层成本确实让 DeepSeek 在这一维度上形成了难以匹敌的优势。
正因为成本优势突出,各家平台也敢于给出极低的收费标准。最近 OpenCode、CommandCode 的 10 美元套餐实际可用额度已经打到 80 至 120 美元,OpenCode 这两天更是直接免费开放。目前在聚合路由平台上,V4.1 Flash 自身的调用量已达到百万亿 Token 级别,一家相当于六七家友商的总和。
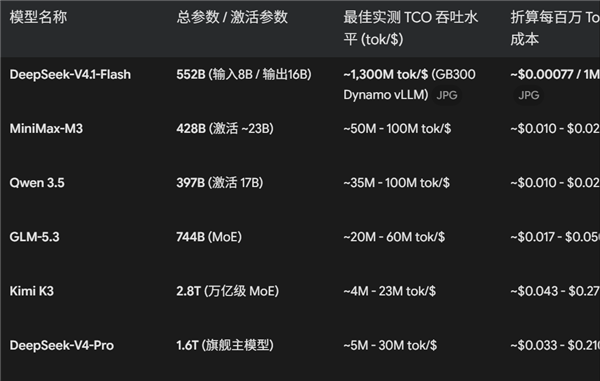
进一步横向比较多个开源大模型的 TCO 成本可以看到:参数量在一万亿以内的其他模型,产出最多也只有 V4.1 Flash 的 1/10;若把范围放到 1.5 万亿至 3 万亿参数量级的模型,成本差距甚至能拉开到 40 至 50 倍以上。
还有一点值得说明:上述 TCO 数据对应的是 V4.1 Flash-0910,而非本次发布的 1017 版本。后者虽然维持原有 API 定价,但大幅优化了 Token 效率、压缩了 Token 消耗量——不同任务场景下降幅度不一,实际体验至少减少了一半用量,这意味着其 TCO 成本还有进一步下探的空间。
本文内容整理自公开资讯,原始出处:3DM游戏网,仅供参考。